Con l’arrivo dell’AI agentica, la sicurezza non riguarda più soltanto il modello, i dati utilizzati o la qualità delle risposte. Abbiamo visto, nei casi di cronaca, come un agente possa accedere alle informazioni aziendali, utilizzare strumenti, modificare applicazioni e prendere decisioni operative, con autonomia crescente, a volte andando oltre le intenzioni dell’azienda. La domanda decisiva diventa quindi: quali azioni un agente è autorizzato a compiere, con quali controlli, come monitorarne le attività?
L’idea che basti mettere in sicurezza l’AI è fuorviante: bisogna governare tutto quello che l’AI può fare e considerarla nel suo ambiente complessivo, considerando che utenti e agenti possono accedere e modificare gli stessi dati e possono utilizzare reciprocamente i risultati delle rispettive operazioni. Va superato quindi un approccio “AI security come componente separata”, in quanto il vero oggetto di governance diventa il processo ibrido umano-agente, compresi gli effetti persistenti prodotti dall’agente.
Un recente paper (Security of Agent-Integrated Software) evidenzia come proteggere separatamente l’agente e l’applicazione tradizionale non garantisca la sicurezza del sistema complessivo. Utenti e agenti possono infatti intervenire sugli stessi dati, utilizzare reciprocamente i risultati prodotti e modificare lo stato dell’applicazione. Gli autori individuano quattro aree di rischio: uso improprio del contesto, violazioni delle autorizzazioni, controllo dell’esecuzione e integrità degli effetti generati.
Questo significa che un agente non dovrebbe ricevere permessi generici e permanenti. Servono autorizzazioni proporzionate al compito, limitate nel tempo e verificabili; tracciamento della provenienza delle informazioni; separazione delle responsabilità; registrazione delle azioni e possibilità di bloccarle o annullarle.
Un secondo studio (FIRE: Failure-Informed Runtime Engineering for Reliable Language-Model Agents) mostra che l’affidabilità può essere migliorata intervenendo sull’ambiente operativo dell’agente. I ricercatori applicano istruzioni contestuali e divieti specifici nei passaggi in cui si erano verificati errori: nei test, il tasso di successo ripetuto del modello più performante passa dal 64,4% al 73,6%. Il risultato suggerisce che una parte importante della sicurezza dipenderà non soltanto dal modello, ma dal livello di orchestrazione che ne governa l’esecuzione.
In conclusione, l’AI governance deve estendersi dall’inventario dei modelli alla gestione delle identità agentiche, dei privilegi, degli strumenti accessibili e degli effetti prodotti. Non basta chiedersi se un’AI sia sicura: occorre stabilire, controllare e dimostrare che cosa può fare.
Una buona notizia è che la stessa evoluzione verso metodologie evolute sta riguardando la difesa cyber. Cisco Talos ha presentato CAIRN, un toolkit che individua malware dotato di componenti AI attraverso prompt, endpoint dei provider, API key e logiche di orchestrazione. Con questo metodo è stato identificato CLOSEDQUORUM, un prototipo di malware Windows che affida a più modelli AI la scelta dell’azione successiva, senza richiedere istruzioni continue da un operatore umano. Talos non ne ha confermato l’impiego in attacchi reali, ma il caso mostra come intere fasi operative possano essere trasferite dall’attaccante al software.
Un Cairn (letteralmente, una pila di pietre o tumulo) è un marcatore lasciato deliberatamente su un sentiero per aiutare gli escursionisti a orientarsi quando il percorso non è chiaro. Gli aggressori che costruiscono malware integrati con l’AI lasciano involontariamente (e inevitabilmente) segnali propri: template di prompt, endpoint provider, chiavi API, termini di jailbreak e altri artefatti integrati nei loro strumenti. Considerando queste stringhe come artefatti cognitivi, o residui lasciati dall’integrazione dell’AI, la soluzione Cisco Talos abilita una nuova metodologia che punta ai metadati per malware integrati nell’AI. Questi artefatti possono essere estratti, collegati e classificati senza modificare il binario sottostante.
Cisco Talos sta rilasciando questa metodologia sotto forma di CAIRN (Cognitive Artifact Intelligence Research Network), un toolkit di ricerca per la ricerca, la classificazione e il tracciamento di malware integrati con IA emergenti. CAIRN dispone di un livello explorer, che crea un grafo strutturato di relazioni cognitive con artefatti per aiutare i difensori a identificare famiglie di malware correlate, infrastrutture e attori di minaccia.
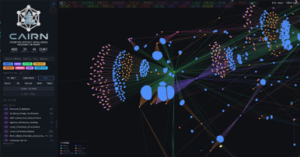
Figura 1. CAIRN explorer collega i binari malware tramite attributi di metadati come submitter, import hash, domain o provider AI.
La pipeline di elaborazione CAIRN estrae artefatti di integrazione AI dai metadati, classifica e costruisce rappresentazioni uniche per tutti i campioni, e raggruppa e grafifica le relazioni del campione.
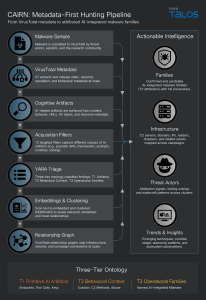
Figura 2. La pipeline di elaborazione CAIRN.
A cura di: Elena Vaciago, Research Manager, TIG – The Innovation Group