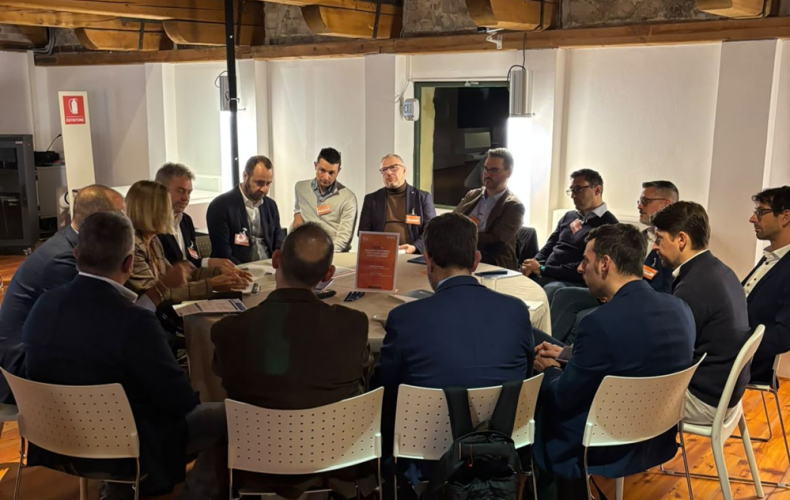
Dal SOC agentico alle responsabilità del management, fino alla capacità di ripristinare i sistemi dopo un attacco: il confronto tra i CISO durante il Tavolo “INCIDENT RESPONSE, TRA COMPLIANCE E AUTOMAZIONE” al CISO PANEL PADOVA 2026 dello scorso 10 novembre, evidenzia la necessità di ripensare processi, deleghe e modelli operativi della risposta agli incidenti.
La gestione degli incidenti cyber sta attraversando una trasformazione profonda. L’accelerazione delle minacce, l’introduzione di nuovi obblighi normativi e le opportunità offerte dall’intelligenza artificiale impongono alle aziende di ripensare non soltanto le tecnologie di difesa, ma soprattutto i processi decisionali e il coinvolgimento del business.
È quanto emerso dal tavolo di lavoro “Incident Response, tra compliance e automazione”, organizzato da The Innovation Group nell’ambito del CISO Panel Padova 2026, con la guida di Massimo Cardin, IT Security Manager di Stevanato Group, nel ruolo di Cyber Coach. Il confronto ha evidenziato tre priorità: accelerare la risposta attraverso l’automazione del SOC, costruire una governance dell’incidente che coinvolga il vertice aziendale e garantire un’effettiva capacità di ripristino e continuità operativa.
Dal SOC tradizionale al SOC agentico: fino a che punto automatizzare?
Uno dei temi che ha maggiormente animato il confronto è stata l’evoluzione dei Security Operations Center. Il modello tradizionale, basato su analisti che esaminano gli alert e decidono le azioni successive, appare sempre più sotto pressione per l’enorme quantità di log da analizzare, la velocità degli attacchi e la difficoltà di reperire competenze specialistiche.
Diversi partecipanti hanno raccontato esperienze di selezione o sostituzione dei fornitori SOC, evidenziando una distinzione tra operatori che investono soprattutto sulle competenze degli analisti e operatori che privilegiano piattaforme tecnologiche, automazione e playbook.
Le proposte più innovative arrivano oggi a prevedere un SOC con un primo livello di analisi interamente automatizzato, nel quale agenti AI correlano le informazioni raccolte dal SIEM e attivano, attraverso sistemi SOAR, azioni di contenimento e remediation per specifici scenari predefiniti. L’obiettivo è ridurre drasticamente i tempi di reazione. Un partecipante ha raccontato come, dopo anni di utilizzo di un SOC tradizionale, la propria organizzazione stia valutando il passaggio a un modello agentico, accettando anche il rischio di un maggior numero di falsi positivi in cambio di una risposta più rapida.
Questa logica, tuttavia, non può essere applicata indiscriminatamente. «L’evoluzione verso SOC sempre più automatizzati, nei quali anche il primo livello di analisi e risposta può essere affidato all’intelligenza artificiale, rappresenta un’opportunità importante per accelerare il contenimento degli attacchi – ha detto Massimo Cardin –. Dobbiamo però valutare attentamente i rischi: un conto è isolare automaticamente un endpoint, un altro è intervenire su un sistema critico o una linea produttiva. In questi casi il controllo umano e la chiarezza delle responsabilità decisionali restano indispensabili».
Per questi sistemi è necessario prevedere eccezioni, livelli di autorizzazione e un controllo umano sulle decisioni più impattanti. La questione centrale non è quindi soltanto quanta automazione introdurre, ma chi mantiene la responsabilità delle decisioni e quali limiti assegnare agli automatismi.
È emerso poi un cambiamento di approccio, che si sintetizza in: “Prima bloccare, poi verificare”. Se un endpoint manifesta un comportamento potenzialmente malevolo, l’isolamento può avvenire automaticamente, prima ancora dell’intervento dell’analista.
«Nella risposta agli incidenti stiamo assistendo a un cambiamento significativo di approccio. In passato si tendeva ad attendere la valutazione dell’analista prima di intervenire; oggi, in molti scenari, la velocità dell’attacco impone di anticipare il contenimento, isolando immediatamente un endpoint sospetto e procedendo successivamente con le verifiche – ha detto Massimo Cardin –. È un cambiamento che richiede però di classificare correttamente gli asset e di definire le eccezioni per i sistemi più critici».
Un’ulteriore sfida riguarda la capacità dei SOC di intercettare i rischi introdotti dall’AI generativa: Shadow AI, prompt injection, utilizzo improprio dei dati e compromissione degli agenti. Alcuni partecipanti stanno valutando strumenti specifici per monitorare queste attività e integrarne gli alert nel SOC. Si tratta però di un ambito ancora in evoluzione, nel quale la copertura dei fornitori non appare sempre completa.
L’incident response è una responsabilità del business
Il secondo messaggio emerso con forza è che un incidente cyber non può più essere gestito come un problema esclusivamente IT. “Le conseguenze di un attacco informatico coinvolgono l’intera organizzazione, con impatti operativi, finanziari e reputazionali – ha detto Massimo Cardin -. Per questo è fondamentale costruire un modello di risposta trasversale, che coinvolga fin dall’inizio il management, il CFO e le diverse funzioni aziendali. La cybersecurity deve diventare parte integrante dei processi decisionali del business».
La NIS2 sta contribuendo ad accelerare questo cambiamento culturale. I nuovi obblighi di gestione e notifica degli incidenti, insieme alle responsabilità attribuite agli organi di amministrazione, hanno portato la cybersecurity all’attenzione dei vertici aziendali.
Un partecipante ha raccontato come il confronto con il Board abbia portato alla costituzione di un Cybersecurity Steering Committee, presieduto dal CFO e composto anche da rappresentanti delle funzioni produttive, con l’obiettivo di assicurare una valutazione trasversale dei rischi e degli impatti sul business.
Il coinvolgimento del vertice, però, richiede soprattutto una catena di comando chiara, definita prima che si verifichi l’incidente. Durante il confronto sono stati illustrati modelli organizzativi articolati su più livelli: una prima valutazione tecnica del SOC, l’attivazione di un gruppo di coordinamento operativo con CIO e responsabili della sicurezza e, nei casi più critici, l’escalation verso un livello decisionale manageriale.
Uno degli aspetti più complessi riguarda la classificazione della gravità dell’incidente. La soglia che determina un obbligo di notifica normativa non coincide necessariamente con quella che identifica una crisi aziendale. Occorre quindi costruire criteri di classificazione che considerino gli impatti operativi, economici e reputazionali, prevedendo piani di risposta differenziati.
Altrettanto importante è stabilire chi possa autorizzare decisioni straordinarie, come l’isolamento di sistemi critici o l’interruzione volontaria di attività produttive. Tenendo presente che se l’isolamento è raccomandabile, lo spegnimento invece va evitato perché può compromettere la conservazione delle evidenze necessarie alle analisi forensi.
Il tema delle deleghe di emergenza resta uno dei punti più delicati. In assenza di responsabilità formalizzate, il rischio è perdere tempo prezioso proprio quando occorre intervenire rapidamente.
Compliance e assicurazione cyber: evitare una gestione a silos
La crescente complessità normativa introduce un’ulteriore difficoltà. NIS2, GDPR e Cyber Resilience Act prevedono adempimenti e processi di segnalazione differenti, che devono essere coordinati senza moltiplicare strutture e procedure separate. Per i CISO è essenziale invece disporre di un processo unitario, capace di coinvolgere tempestivamente IT, sicurezza, DPO, funzioni legali, comunicazione e management, identificando con precisione il momento dal quale decorrono gli obblighi di notifica.
La discussione ha affrontato anche il ruolo delle polizze cyber, con particolare attenzione alle esclusioni contrattuali, alla copertura dei danni da interruzione dell’attività e alle conseguenze economiche che possono manifestarsi anche nei mesi successivi all’incidente. È emersa la necessità di verificare preventivamente le condizioni assicurative, soprattutto in presenza di sistemi obsoleti, vulnerabilità note o decisioni di fermo volontario. La copertura non può essere data per scontata e dipende dalle clausole contrattuali e dalle misure di sicurezza effettivamente adottate.
Esercitazioni e tabletop, banco di prova della resilienza
Un altro punto di convergenza è stata la distanza che spesso separa la documentazione formale dall’effettiva capacità di gestire un’emergenza. Disporre di un Incident Response Plan non significa necessariamente essere pronti ad applicarlo. Le esercitazioni tabletop e le simulazioni permettono di verificare ruoli, comunicazioni, tempi di attivazione e capacità di coordinamento.
Sono state condivise esperienze positive di esercitazioni che hanno coinvolto non soltanto i team IT, ma anche le funzioni operative e il management. In un caso, un’esercitazione con numerosi gruppi di lavoro ha prodotto interpretazioni differenti dello stesso scenario aziendale, facendo emergere la necessità di definire un playbook comune. In un altro caso, una simulazione ha favorito il confronto tra IT e OT, rendendo evidenti lacune organizzative e conoscenze insufficienti sui processi di risposta.
Le difficoltà però permangono, ad esempio legate alla mancanza di tempo, di competenze specifiche e di disponibilità delle funzioni di business. Anche l’attivazione di specialisti esterni dovrebbe essere verificata concretamente, controllando tempi di intervento e modalità di accesso ai sistemi.
Un’esperienza particolarmente interessante riguarda il coinvolgimento periodico del management attraverso la presentazione dei “near miss”, degli incidenti evitati e delle minacce osservate nel proprio settore. Questo approccio contribuisce a trasformare la cybersecurity da argomento tecnico a componente della cultura aziendale.
Resta fondamentale anche il riesame successivo all’incidente: senza un’analisi delle cause e delle criticità emerse, il rischio è ripetere gli stessi errori.
Vulnerability management: l’automazione incontra i limiti dei sistemi legacy
Il confronto ha toccato anche l’evoluzione del vulnerability management. La crescita esponenziale delle vulnerabilità note e la difficoltà di intervenire tempestivamente su infrastrutture complesse rendono sempre più importante l’impiego di strumenti automatici e agenti AI per individuare, prioritizzare e gestire le esposizioni. Anche in questo caso, tuttavia, l’automazione richiede verifiche e ambienti di test: applicare automaticamente una patch a un sistema produttivo critico può comportare rischi operativi rilevanti.
Particolare attenzione è stata dedicata nella discussione al tema dei sistemi legacy e delle componenti software non più supportate, soprattutto negli ambienti industriali. Quando non è possibile aggiornare, diventano fondamentali l’inventario degli asset, la segmentazione di rete e l’adozione di controlli compensativi, come il virtual patching. La conoscenza puntuale delle vulnerabilità presenti costituisce inoltre un elemento importante nel rapporto con gli assicuratori.
Disaster Recovery, come ripristinare in sicurezza
L’ultimo tema affrontato è stato quello del Disaster Recovery, strettamente collegato all’incident response ma distinto per obiettivi. Se la risposta all’incidente punta a contenere la minaccia e limitarne gli effetti, il Disaster Recovery deve assicurare il ripristino dei sistemi e dei dati necessari alla continuità del business. Anche il passaggio dall’una all’altra fase richiede una decisione esplicita e responsabilità definite.
Il punto centrale emerso dalla discussione è che non basta disporre di backup: occorre essere certi che i dati ripristinati siano integri e non compromessi. Sono state richiamate le opportunità offerte dai backup immutabili e dalle clean room, ambienti isolati nei quali verificare i dati prima di riportarli in produzione. Un partecipante ha illustrato un approccio basato su verifiche periodiche del restore e sulla richiesta al fornitore di attestare la corretta configurazione e il funzionamento del software di backup.
L’efficacia del Disaster Recovery dipende inoltre dalla capacità del business di identificare realmente processi, applicazioni e dati critici. La Business Impact Analysis diventa quindi uno strumento indispensabile, ma richiede un coinvolgimento attivo delle funzioni aziendali, non sempre preparate a valutare le proprie dipendenze tecnologiche.
In conclusione
Dal confronto è emersa un’indicazione trasversale: l’evoluzione dell’incident response non può essere affidata soltanto all’adozione di tecnologie più avanzate o all’adeguamento alle normative: serve un forte coinvolgimento del business e una maggiore presa di coscienza collettiva. L’AI e l’automazione possono migliorare sensibilmente i tempi di rilevazione e contenimento, mentre la compliance contribuisce a rafforzare processi e responsabilità. Ma la resilienza dipende soprattutto dalla capacità dell’organizzazione di prendere decisioni rapide, coordinate e consapevoli.
Sapere chi decide, quali sistemi proteggere prioritariamente, quando coinvolgere il vertice e come ripristinare le attività in sicurezza rappresenta oggi il vero salto di maturità richiesto alle aziende. Il passaggio decisivo è trasformare l’incident response da procedura tecnica a capacità organizzativa, verificata attraverso esercitazioni e integrata nei processi di governo del rischio di business.
A cura di: Elena Vaciago
Research Manager, The Innovation Group