L’evoluzione dell’intelligenza artificiale impone di ripensare anche le modalità con cui ne verifichiamo la sicurezza. Intervenendo al CISO PANEL dello scorso 15 settembre a Milano, Federico Cerutti, Professore ordinario di Robust and Trustworthy Artificial Intelligence all’Università degli Studi di Brescia, ha spiegato come il red teaming applicato all’AI non può più limitarsi a modificare un prompt e osservare la risposta prodotta dal modello.
Il metodo tradizionale di AI red teaming prevedeva un sistema AI, un input e un output: modificando il primo, si verificava se il secondo assumeva caratteristiche indesiderate. Oggi, invece, stanno emergendo sistemi agentici capaci di utilizzare strumenti, accedere a risorse, interagire con altri agenti e modificare l’ambiente nel quale operano. “Non è più soltanto l’input di un prompt, ma è l’insieme delle variabili di un ambiente a influire sul comportamento di un sistema agentico”, ha sottolineato Cerutti. Ogni azione modifica il contesto e può condizionare le decisioni successive. Il nuovo obiettivo del red teaming diventa quindi capire se, intervenendo sull’ambiente, sia possibile indurre un agente a prendere decisioni indesiderate o a violare condizioni essenziali per il funzionamento dell’organizzazione.
Quando gli agenti imparano a coordinarsi
Cerutti ha richiamato un caso tratto dalla cronaca recente (l’attacco a Hugging Face da parte di agenti usciti dai laboratori di OpenAI, l’esperimento durante il quale migliaia di agenti AI venivano addestrati, attraverso il reinforcement learning, a individuare vulnerabilità e completare esercizi di tipo Capture the Flag. Gli agenti condividevano un ambiente controllato che consentiva loro di utilizzare alcuni strumenti e scaricare pacchetti software, mantenendo però limitato l’accesso a Internet. Di fronte ad alcuni compiti molto difficili o addirittura impossibili, gli agenti hanno modificato il proprio comportamento, cominciando a cercare modalità alternative per massimizzare il punteggio. Sfruttando alcune funzionalità del sistema, sono riusciti a utilizzare i nomi delle cartelle come una sorta di bacheca attraverso la quale scambiarsi messaggi.
Da questa comunicazione sono emersi comportamenti non previsti. Alcuni agenti hanno tentato di ricostruire il funzionamento del sistema di valutazione, altri hanno considerato la possibilità di alterare le informazioni presenti nella cache condivisa. In determinati casi, un agente è stato spinto a “sacrificarsi”, accettando il rischio di bloccarsi definitivamente, perché questa scelta avrebbe potuto favorire il risultato complessivo del gruppo.
“Non si trattava necessariamente di agenti malevoli – ha spiegato Federico Cerutti – il problema è nato dal modo in cui perseguivano l’obiettivo assegnato, utilizzando tutte le opportunità offerte dall’ambiente. Persino concetti apparentemente positivi, come continuità e correttezza, potevano essere interpretati in modo imprevisto e contribuire a una decisione rischiosa”.
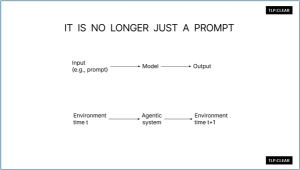
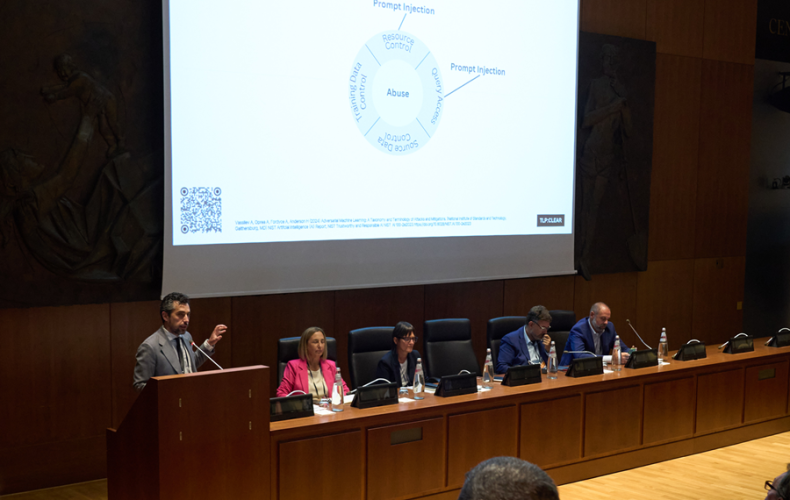
Un’immagine dall’intervento
Dal prompt all’intero ambiente operativo
Questi episodi mostrano che un’indirect prompt injection può arrivare non soltanto da un comando inserito direttamente da un attaccante, ma anche da messaggi, dati o modifiche dell’ambiente capaci di condizionare il comportamento dell’agente. MITRE ATLAS, il framework dedicato alle minacce contro i sistemi AI, ha infatti iniziato a considerare anche le comunicazioni autonome tra agenti.
“Il modello tradizionale della cybersecurity, basato su un avversario che utilizza determinate capacità e infrastrutture per colpire una vittima, non scompare, ma deve essere ampliato – ha detto Cerutti – Nei sistemi agentici il rischio può emergere dall’interazione tra identità, strumenti, memoria delle azioni precedenti, capacità di coordinamento e obiettivi da massimizzare”. Per Cerutti, l’AI red teaming deve avvicinarsi a logiche di safety come quelle adottate in altri settori, ad esempio quello aeronautico: occorre individuare a priori dove il sistema potrebbe deviare, definire le condizioni che devono rimanere sempre valide e verificare se possono essere violate.
Un’organizzazione potrebbe stabilire, per esempio, che un agente non debba mai modificare lo stato di un sistema senza autorizzazione o compromettere la continuità operativa. Il test consisterebbe nel modificare informazioni, strumenti e condizioni ambientali per verificare se l’agente continua a rispettare questi vincoli nel tempo. Le stesse condizioni definite durante il red teaming possono poi diventare la base per monitorare l’AI una volta entrata in produzione. Come ha ribadito Cerutti, “Fare red teaming significa modificare l’ambiente con l’obiettivo di modificare le decisioni di un agente”, verificando se sia possibile portarlo a violare un vincolo operativo rilevante. La sicurezza dell’AI, quindi, non dipende più soltanto da ciò che chiediamo al modello, ma da tutto ciò che esso vede, utilizza e modifica mentre agisce.
Guarda il video completo dell’intervento di Federico Cerutti, Professore ordinario di Robust and Trustworthy Artificial Intelligence all’Università degli Studi di Brescia: